我的2026年AI Skill 实战指南
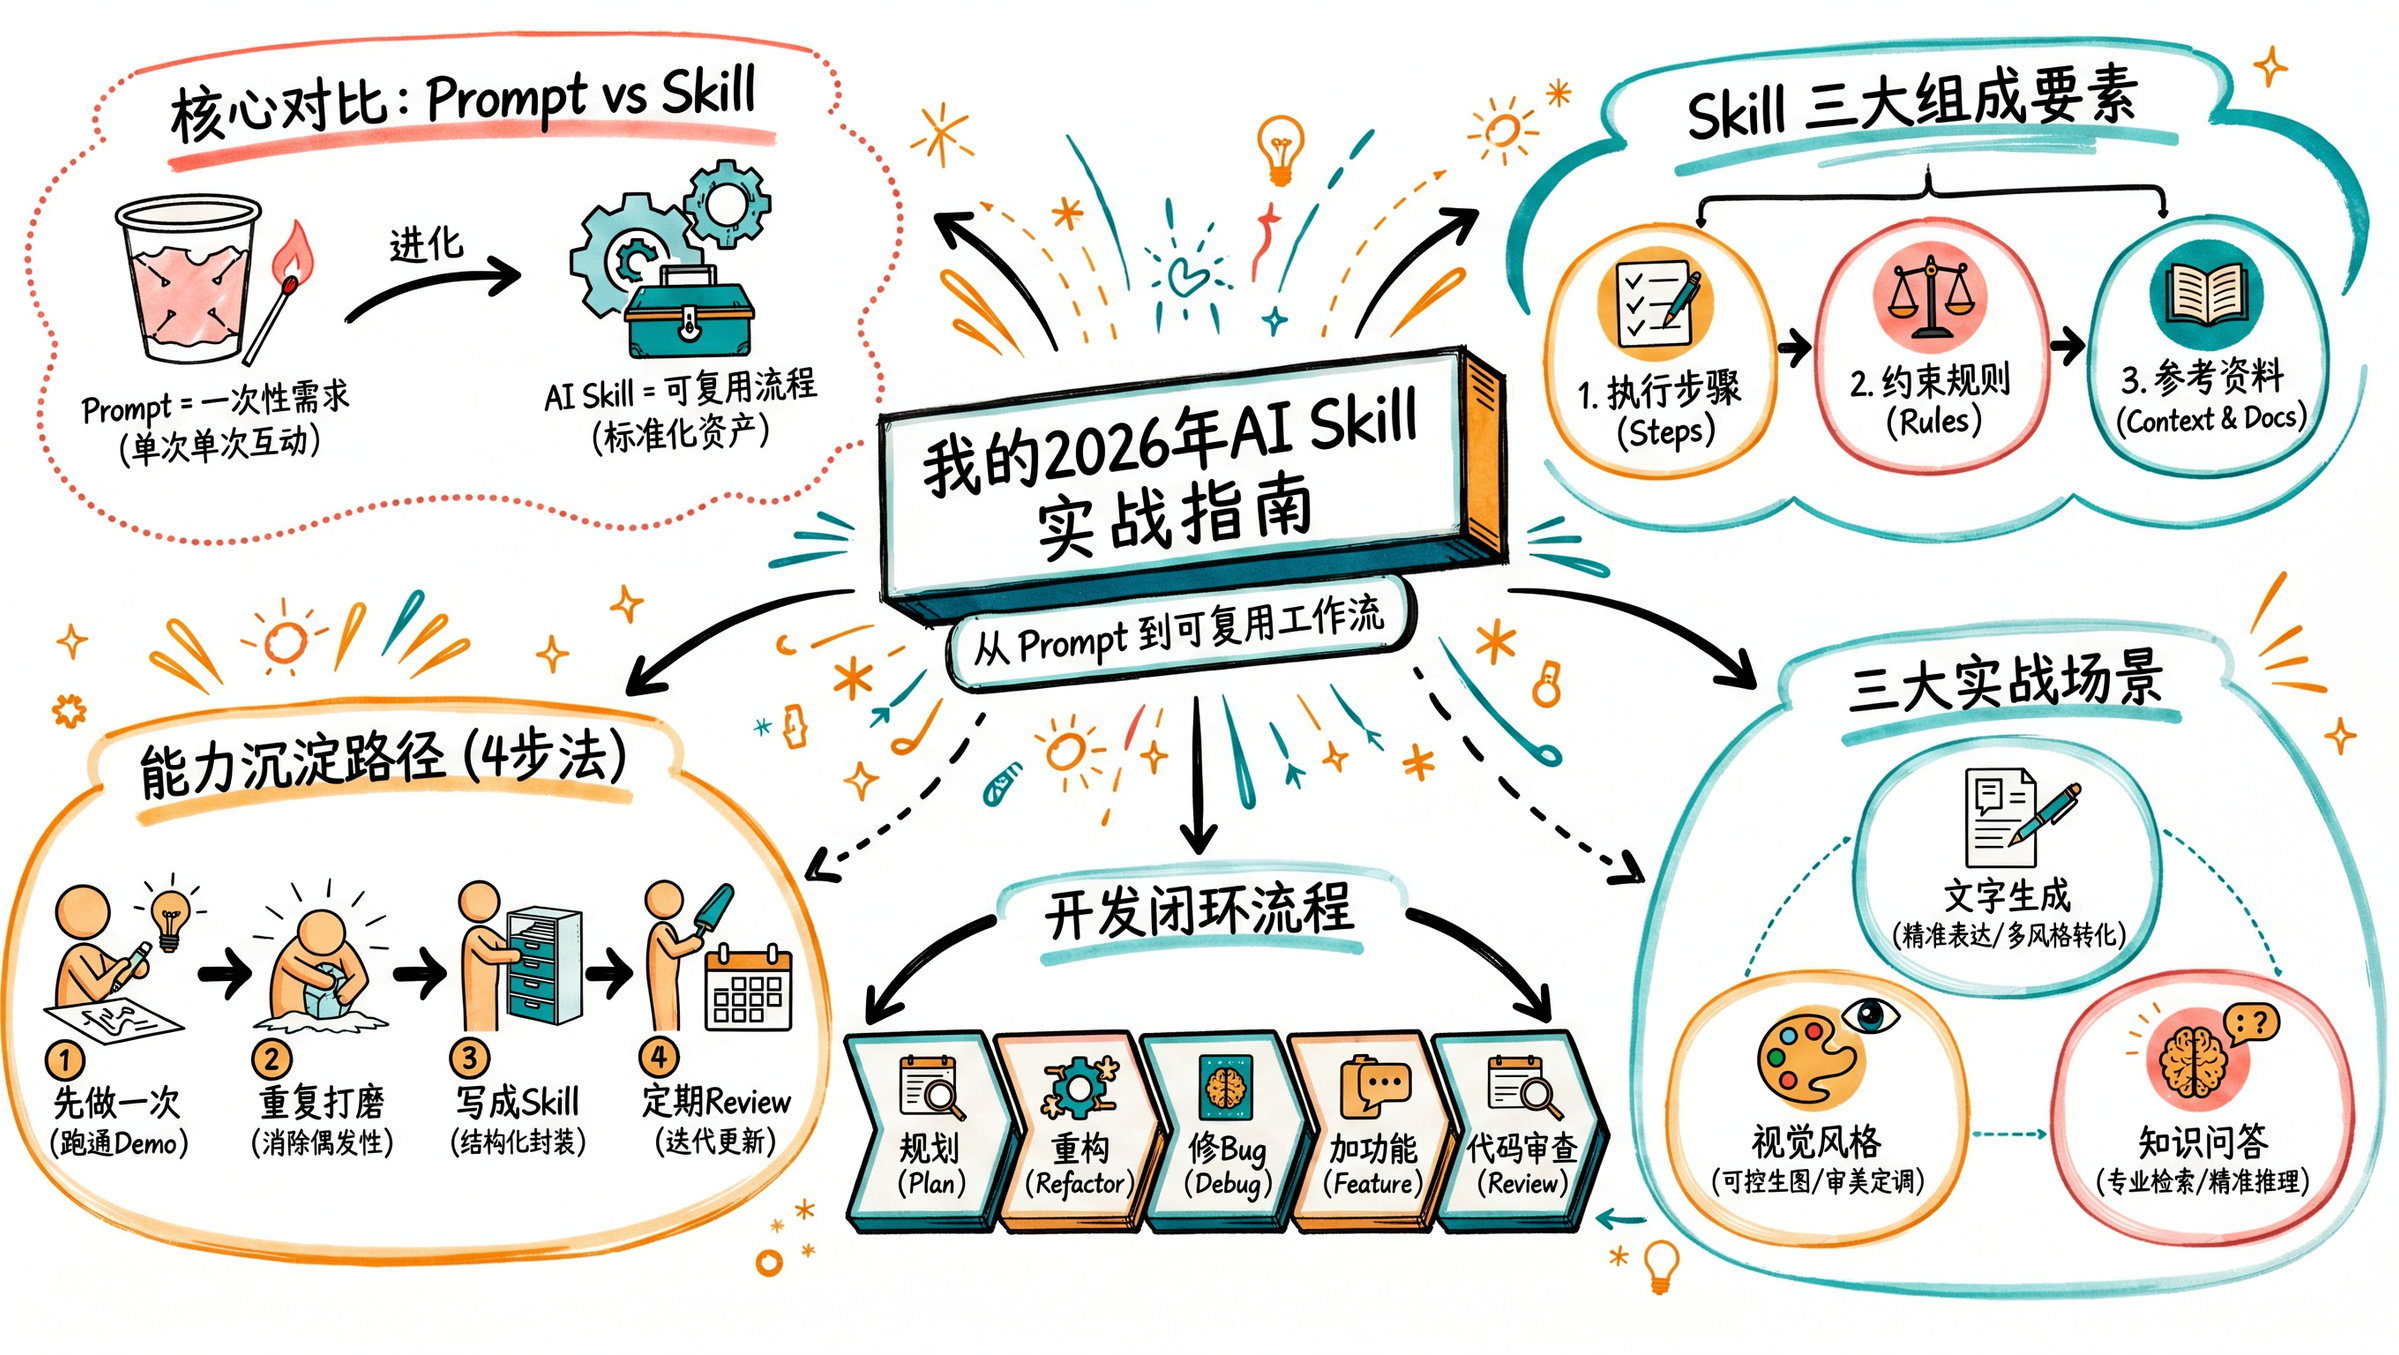
AI 领域绕不开的一个核心概念就是 Skill。它并不是一阵风就会过去的噱头,而是一种能够长期沉淀下来的能力——通俗地说,Skill 就是把我们的工作流程和实战经验结构化、文本化,沉淀为 AI 可复用的标准动作。
和 AI 协作时,最让人头疼的往往是两个问题:
- 每次开新会话就清零,一切从头解释:长期项目会积累大量上下文——做过的决策、试过的方法、暂时搁置的进度。没有明确的会话边界,这些信息就会在切换对话时流失。
- 很多工作在反复重演:同一件事做上三次以上,如果每次都靠临场发挥、重新交代要求,就是极大的时间与精力浪费。
Skill 正是为了解决这两个问题而生的。
一、 Skill 是什么?它和 Prompt 有什么不同?
用一句话来区分:Prompt 用来表达当下的单次需求,Skill 则适合保存反复使用的方法。
Skill 并不是一句临时的提示词,而是一套包含步骤、决策逻辑以及特定环境适配的完整工作流——明确做什么、按什么顺序做,以及做完如何验收。
在工程与使用层面,Skill 还有两个非常关键的价值:
- 按需加载,省上下文也省 Token:不是把所有技能一股脑塞进上下文,而是用到哪个再载入哪个,不触发时不占空间。
- 它是记忆的一部分:它不是随手写的一段临时说明,而是你把“某件事应该怎么做”固化下来的长期资产。
二、 Skill 的设计原则、内部结构与六段式模板
1. 三类常见的 Skill 内容
从内容形态来看,Skill 大致可以分为三类:
- 任务 / 做事类 Skill:规定具体执行步骤与验收标准的流程型技能。
- 风格 / 排版类 Skill:沉淀视觉版型、配色规范、字体字号或行文风格的规范型技能。
- AI 知识库类 Skill:绑定参考资料、制度法规或领域术语,让回答有据可查的知识型技能。
2. 三条核心设计原则
- 设计流程尽量简单:步骤清晰、边界明确,避免过度设计。
- 语言简单,但尽量用专业术语:表达直白易懂,同时用准确的工程/领域词汇减少歧义。
- 定期 Review:随着项目与工具演进,定期回看并清理过时规则。
Tips:使用 ASD STE100的方式解释/描述 xxx
3. 内部结构:Steps + Reference(三层架构)
Skill 的主体可以拆解为步骤(Steps)与参考资料(Reference)两块,具体分为三层:
SKILL.md中的 Steps(最上层):说明 Agent 要做什么、按什么顺序做,每个 Step 都有一个可判定的完成标准。SKILL.md中的 Reference(次要层):存放随时需要查阅的定义与规则,很多时候它们是一组平级的同级规则。- 外部文件的 Reference(按需引用层):通过 Context Pointer(上下文指针)指向外部文件,只有在被触发时才载入。既可以是 Skill 文件夹里的兄弟文件(例如
GLOSSARY.md),也可以是 Skill 系统之外、任何 Skill 都能引用的通用文件。
4. 实用的“六段式模板”
编写结构化 Skill 时,可以参考以下六段式模板:
- Overview(概述):这个技能是用来解决什么问题的。
- When to Use(何时使用):明确适用的场景与触发条件。
- Process(流程):按顺序执行的编号步骤。
- Common Rationalizations(常见的自我合理化借口):列举 Agent 想跳过某一步时可能找的借口,并逐条予以驳斥。
- Red Flags(危险信号):提示技能规则正在被违背或绕过的迹象。
- Verification(核验):收工前的检查清单。
三、 怎么生成、触发、安装与管理 Skill?
1. 生成与迭代:先做一次,再固化成流程
“一件事做三次以上,就值得变成一个 Skill。”
生成 Skill 主要有两条路径,但底层动作是一致的:先手动完整跑通一次任务,再让 AI 把它固化成 Skill。
- 路径一:先对话,再让 AI 总结成 Skill。在聊天过程中觉得思路和产出已经很顺了,直接让 AI 把这段协作过程提炼成 Skill。
- 路径二:按框架有意识地总结。围绕“人设 / 目的、操作经验、输出格式、补充说明”或六段式结构,主动梳理并生成 Skill。
迭代提醒:Skill 的初版很少完美,因为它往往“过度拟合”了那一次特定会话——这很正常。下次用的时候再修,而且**修正尽量在会话内完成,不要直接打开硬改
SKILL.md**。
2. 怎么触发:自动 vs 手动
- 自动触发:依靠
description中的描述自动匹配加载。description里只需写明“在什么条件下会触发”即可,但自动触发存在一定概率不命中的情况。 - 手动触发:通过斜杠命令(如
/skill-name)显式调用,触发更可靠,代价是需要记住对应的 Skill 名称。
3. 怎么获取现成的 Skill
除了自己沉淀,也可以直接安装社区或官方提供的 Skill:
- 使用
npx skills add安装:例如安装kepano/obsidian-skills(包含五个技能文件,帮助 Claude Code 掌握完整的 Obsidian 格式规范)。 - 通过
git clone放入.claude/skills/**:拉取仓库到对应技能目录即可使用。 - 下载ZIP 包放入
.claude/skills/**:例如微信读书 Skill[https://cdn.weread.qq.com/skills/weread-skills.zip]。 - 工具自带命令安装:例如
playwright-cli提供的技能安装方式:
playwright-cli install --skills
执行后会直接安装到当前项目的 .claude/skills/playwright-cli。如果要适配 Codex,只需把 .claude 改为 .codex,随后在 Codex 命令行中输入 /skill 即可验证。
4. 目录结构与存放位置
全局通用配置通常位于 ~/.claude/ 下,大致结构如下:
~/.claude/
 ├── CLAUDE.md              ← 由你编写的全局规则
 ├── settings.json          ← 由你配置
 ├── settings.local.json    ← 个人覆盖配置,已加入 gitignore
 ├── skills/                ← 由你构建的全局技能
 ├── agents/                ← 由你构建的全局智能体
 └── projects/              ← Claude 的内部记录目录,不属于你的配置
     ├── -Users-mariaweaver/
     │   └── memory/        ← 从 ~/ 启动的会话所使用的记忆目录
     └── -Users-mariaweaver-projects/
         └── memory/        ← 已失效的目录
项目级目录下也会有类似的 .claude/skills/ 与 .claude/agents/,仅在当前项目中启用;而不依赖具体项目、跨场景通用的技能(如写作、规划),更适合放在全局通用目录中。
此外,还可以在 ~/.claude/guides 目录下维护评估指南、BI 展示风格等 .md 规范文件,方便随时复用。
四、 三大实战场景:把常见需求变成可复用 Skill
如果还不确定从哪里开始,可以用这两种简单方式起步:
- 流程还不清楚:先和 AI 一起完成几次任务,再从对话中提取共同要求。
- 流程已经明确:直接给出步骤、参考资料和交付要求,让 AI 生成 Skill。
先打磨好一个高频单点任务,再逐步把多个 Skill 串成工作流(例如:课程设计 → 教材编写 → 简报制作)。下面看三个典型场景的示例:
1. 文字生成:固化处理流程(以课程设计为例)
每次课程主题不同,但前期沟通与输出结构往往高度一致,适合做成固定流程的 Skill。
示例提示词 请制作“课程设计小帮手”Skill。先询问课程主题、课程说明、使用软件、学习成果与受众,再输出课程名称建议、100 字内课程简述和学习目标。先显示文字,等我确认后,再制作排版好的 Word。请交付
SKILL.md和 ZIP 压缩包。
- 实际效果:根据来回对话沉淀出的规则,生成完整的课程设计 Skill,后续按流程推进即可。
2. 图文生成:把参考图变成视觉规范(以简报风格为例)
如果偏爱某种版式或视觉风格,可以直接提供参考图,让 AI 提炼版型、配色和字体规则。
示例提示词 请依据四张参考图制作简报风格 Skill:第一张为封面,第二张为单元页,第三、四张为内页。保留白底、黑色手写感标题、深青绿强调和大留白。标题固定 50pt,正文 20pt,内容过多时拆页,不缩小字号。请附参考图,打包成 ZIP。
- 实际效果:生成包含
SKILL.md和四张参考图的压缩包,通过格式校验后,后续直接用/skill名称即可复用一致的设计风格。
3. 知识库问答:让回答有据可查(以制度法规为例)
当希望 AI 严格依据制度或法规回答时,需要把参考资料和引用格式写进 Skill。
示例提示词 请依据我提供的法规 PDF,制作“劳工请假规则查询”Skill。回答时先引用条文,注明法规名称、条号和 PDF 页码,再用白话解释。资料未涵盖的内容,要明确说明。请将
SKILL.md与参考 PDF 一起打包成 ZIP。
- 实际效果:围绕指定文档构建出可溯源的知识库问答技能,减少瞎编与遗漏。
五、 五大开发流程提示词模板:覆盖高频编码场景
除了通用工作流,日常软件开发中的常见动作也可以拆解成清晰的步骤与提示词(同样适合进一步沉淀为团队或个人的标准流程与 Skill):
1. 全新项目(无历史包袱,重点建立结构与规范)
- 第一步:规划项目结构
我要做一个任务管理应用,功能包括:
- 用户注册和登录
- 创建、编辑、删除任务
- 任务分类和标签
- 任务提醒
请帮我:
- 推荐合适的技术栈
- 设计项目目录结构
- 规划数据库表结构
- 第二步:搭建基础框架
按照刚才的规划,帮我:
- 创建项目目录结构
- 初始化配置文件(
package.json、.env等)
- 第三步:逐个实现功能
现在实现用户注册功能,要求:
- 邮箱和密码注册
- 密码加密存储
- 邮箱验证
注意:
- 文字要简洁清晰
- 要 AI 做的事情尽量控制在 3 个以内
2. 重构代码(先定目标与安全网,再小步替换)
步骤 1:确定重构目标(自己完成)
要解决什么问题?(代码重复、结构混乱、性能问题?)
重构的范围有多大?
能接受的风险程度?
步骤 2:制定重构计划(和 AI 一起)
这三个函数(
getUserList、getArticleList、getCommentList)有很多重复代码,都是做分页、排序、筛选。 请帮我:
- 分析重复的部分
- 提出重构方案
- 评估重构的风险
步骤 3:准备安全网(让 AI 帮你)
在重构之前,先帮我写测试用例,确保重构后功能不变。
步骤 4:逐步重构(AI 执行,自己验证)
步骤 5:验证结果(自己完成)
3. 修复 Bug(先收集与定位,再加防御并回归验证)
步骤 1:收集信息(自己完成)
错误信息是什么?
如何复现这个问题?
什么时候开始出现的?
影响范围有多大?
步骤 2:定位问题(让 AI 帮你)
用户反馈:点击“提交订单”按钮后,页面卡住不动 浏览器控制台报错:
TypeError: Cannot read property 'id' of undefined错误发生在checkout.js第 45 行 请帮我:
- 分析可能的原因
- 找到相关的代码
- 检查数据流向
步骤 3:分析根因(和 AI 一起)
看看这个
user对象是从哪里来的,检查在什么情况下user会是undefined。步骤 4:实施修复(AI 生成,自己审查)
添加防御性代码,检查
user是否存在;如果
user不存在,跳转到登录页;添加友好的错误提示。
步骤 5:验证修复(自己完成)
按原步骤复现,确认问题解决;
测试相关功能,确保没有引入新问题;
思考是否有其他地方存在类似问题。
4. 新增功能(先对齐边界与现有代码,再分步落地)
步骤 1:理解需求(自己完成)
要实现什么功能?
输入和输出是什么?
有哪些边界条件和异常情况?
性能和安全要求是什么?
步骤 2:了解现有代码(让 AI 帮你)
我需要实现用户评论功能,请帮我:
- 看看项目中有没有类似的功能
- 找到用户数据和文章数据的存储方式
- 了解项目的数据库操作规范
- 步骤 3:制定实现计划(和 AI 一起)
基于刚才的分析,实现评论功能需要:
- 创建评论数据模型
- 实现评论的增删改查 API
- 在前端添加评论展示和发表功能
请帮我确认这个计划是否合理,有没有遗漏的地方。
- 步骤 4:实现功能(AI 生成,自己审查)
按照计划,先实现评论数据模型,要求:
- 包含评论内容、作者、文章 ID、创建时间
- 支持评论的嵌套回复
- 添加必要的索引
- 步骤 5:测试验证(自己完成)
- 手动测试主要流程;
- 测试边界情况(空内容、超长内容等);
- 测试权限控制(不能删除别人的评论);
- 让 AI 帮你写自动化测试。
5. 代码审查(先看全貌与风险,再审业务与细节)
步骤 1:快速了解改动(让 AI 帮你)
总结这次 PR 做了什么改动,主要修改了哪些文件。
步骤 2:检查常见问题(让 AI 帮你)
检查这次改动:
- 有没有安全问题(SQL 注入、XSS 等)
- 有没有性能问题(N+1 查询、内存泄漏等)
- 有没有明显的 Bug
- 代码风格是否符合项目规范
步骤 3:深入审查(自己完成)
业务逻辑是否正确;
是否考虑了边界情况;
是否有更好的实现方式;
是否需要添加测试。
步骤 4:给出反馈(自己完成)
指出需要修改的地方,解释修改原因,并提供改进建议。
写在最后
真正值得保存的,是那些你每次都会重复交代、反复修正的要求。把它们整理成清晰的工作流和 Skill,下一次就能直接接着用。